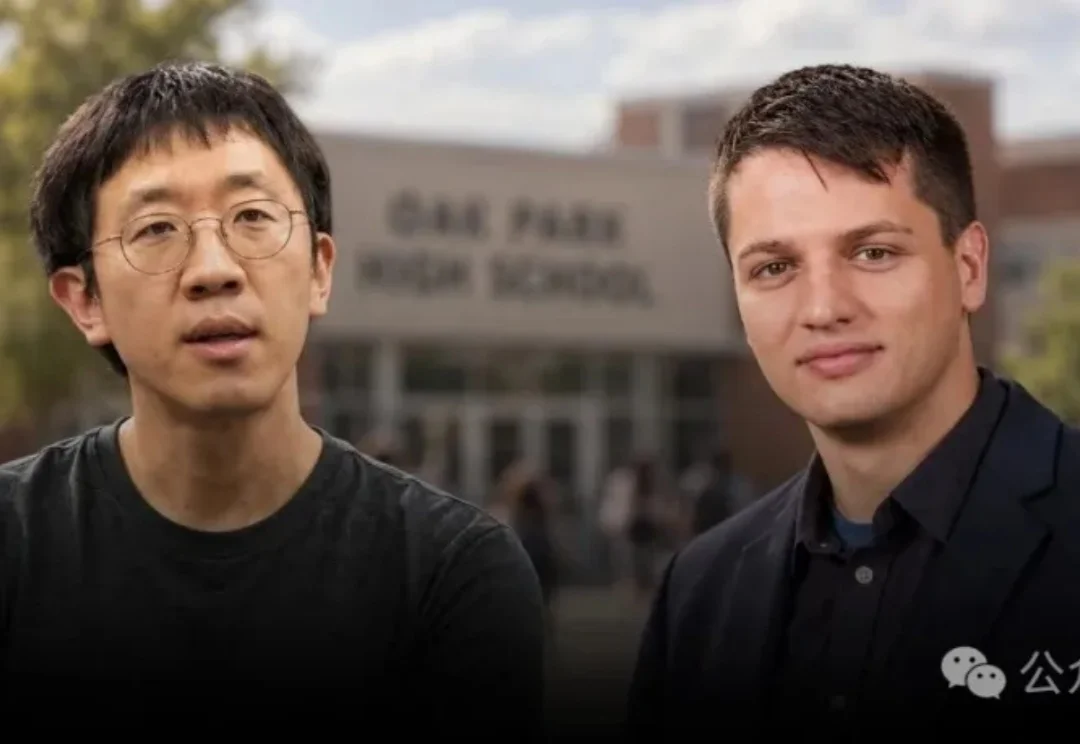
全网震撼!菲奖得主未解难题,竟被两名高中生用AI攻破了
全网震撼!菲奖得主未解难题,竟被两名高中生用AI攻破了新智元报道 你敢信? 人没上大学,研究已经接上了「菲尔兹奖得主」的工作了。 就在今天,UCLA数学圈传出了一条让所有人震惊的消息—— 两名高中生Aayush Bathija和Prince Rohatg
来自主题: AI技术研报
5833 点击 2026-09-14 10:22

 搜索
新智元报道 你敢信? 人没上大学,研究已经接上了「菲尔兹奖得主」的工作了。 就在今天,UCLA数学圈传出了一条让所有人震惊的消息—— 两名高中生Aayush Bathija和Prince Rohatg
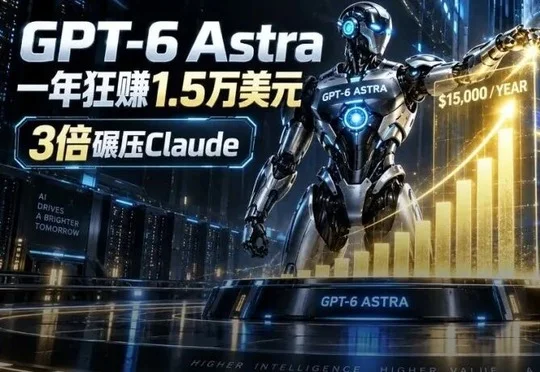
OpenAI的GPT-6 Astra在Vending-Bench 2模拟经营测试中以平均15,515美元的账户余额首次登顶,接近Claude Fable 5.1的3倍,展现出更强的长期议价能力、规则执行力与供应商风险管理水平。
OpenAI Codex团队主张模型越强Harness应越轻量,Anthropic Claude Code团队则认为模型越强Harness反而需越复杂以支撑Agent长时间自主运行,两者共同揭示了Agent Harness正经历从辅助层向承重结构转变的结构性变化。
话说。 Claude发布了一则Claude code团队如何使用Claude code持续优化Claude code的访谈视频。
一支约 20 人的团队,做出了 Claude Code、MCP 和 Claude Design。
Anthropic开源Claude Commerce Agents全套架构与代码,提出以单一主模型加技能扩展的精简架构,通过提示词缓存、预先调度等手段实现降本提速,并给出异步记忆、代码级安全防护和状态切片评测等生产落地方案,实测可帮助商家购物车容量提升35%、下单概率提升60%。
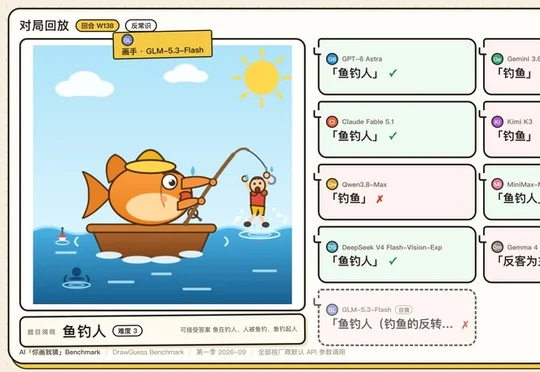
我们自建的"你画我猜 Benchmark"第一期用150个词、1350张SVG画作对8款模型进行互画互猜测试,最终GPT-6 Astra以75.5分险胜Gemini 3.8 Flash与Claude Fable 5.1,结果显示思考更多或花费更多的模型并未稳定取得更高分,且部分模型连自己的画都认不出。
腾讯WorkBuddy、阿里QwenWork等中国大厂AI办公产品出海面临获客成本高企、难以撼动Claude Code和Codex等海外成熟工具用户心智、品牌信任与数据合规门槛较高以及本地化不足等现实阻力,尽管中国AI模型凭借性价比在海外广受欢迎,国产AI办公Agent却尚未打开海外市场。
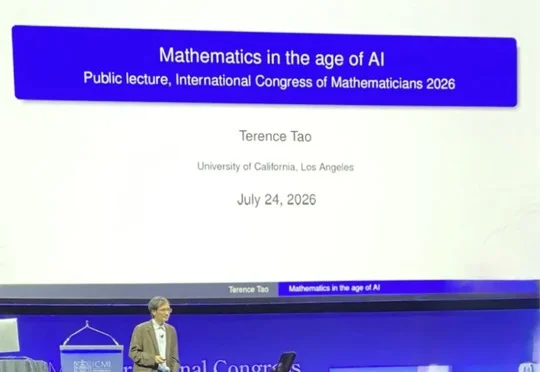
在Epoch AI与曼彻斯特大学发布的FrontierMath Erdős基准测试中,GPT-6 Astra以3%得分率成为唯一非零分模型并解开5道Erdős难题,而GPT-5.6 Sol、GPT-5.5、Fable 5.1与Claude Fable 5均交白卷。
Manus团队在评测模型深度研究报告质量时,构建了"信息量"与"隐喻率"两项指标,分别通过抽取事实点和统计每百句隐喻数量来衡量信息密度与文风易读性,在覆盖9个主流模型36道题目的Research Bench测试中发现Claude Fable-5隐喻率最高、GPT旗舰模型信息密度低于Claude系列。